Opengram: как устроен сервер, который говорит на MTProto
Совместимость с Telegram — это не «поддержать API». Это принять чужие решения целиком: чужой бинарный протокол, чужую криптографию рукопожатия, чужую модель обновлений. Клиент не будет подстраиваться под сервер: он либо получает ровно те байты, которых ждёт, либо просто рвёт соединение без объяснений.
Opengram — self-hosted мессенджер на Go, который говорит на MTProto по-настоящему. Ниже — не пересказ протокола, а разбор трёх мест, где архитектура решает: два разных входа в одну систему, порядок сообщений и раскладка хранилищ.
#Два входа, одно ядро
У Opengram два режима работы, и это первое архитектурное решение. Полный режим — настоящие клиенты Telegram подключаются по MTProto. Встроенный режим — другие приложения фленота поднимают у себя чат один-на-один через обычный REST+WS и подписанный токен хост-приложения.
Соблазн — сделать две системы. Ошибка та же: две реализации «отправить сообщение» разойдутся в поведении за пару месяцев, и разойдутся молча.

Поэтому граница проведена так: шлюз занимается только протоколом — разбирает байты, держит сессию, отвечает в нужном формате. Всё, что означает «отправить сообщение», «создать диалог», «прочитать историю», живёт в internal/messaging и вызывается обоими входами одинаково. MTProto-шлюз в этой схеме — переводчик, а не второй сервер.
Побочный эффект приятный: любую фичу достаточно написать один раз, и она сразу есть в обоих режимах.
#Порядок сообщений — главная сложность
Telegram не рассылает клиенту «просто события». У каждого пользователя есть pts — монотонный счётчик состояния. Клиент помнит последний увиденный pts, а когда возвращается в сеть, спрашивает updates.getDifference и получает всё, что пропустил. Из этого следуют жёсткие требования:
- ▸номера идут строго подряд, без дырок;
- ▸номер, однажды выданный, нельзя выдать повторно с другим содержимым;
- ▸запись «что произошло» должна пережить падение сервиса ровно между выдачей номера и записью события.
Последний пункт — тот самый, где обычно ломаются самодельные реализации. Соблазнительно сделать так: взять счётчик в Redis, инкрементнуть, потом записать событие в основное хранилище. Между этими двумя шагами процесс может умереть — и в ленте пользователя навсегда останется дырка, из-за которой клиент будет бесконечно просить дифф, которого нет.
Решение в Opengram нарочито скучное: номер и запись о нём выдаются в одной транзакции Postgres.
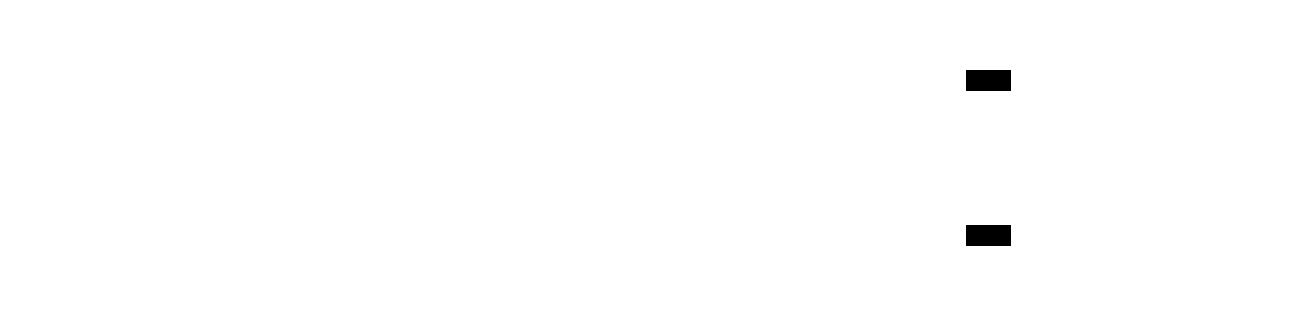
Блокировка строки (FOR UPDATE) сериализует выдачу номеров по одному пользователю — не по всей базе. Запись pending в той же транзакции гарантирует: номер существует только вместе с описанием того, за что он выдан. А ON CONFLICT DO NOTHING по ключу идемпотентности делает повтор безопасным: клиент, переславший запрос после таймаута, получит тот же самый pts, а не второе сообщение.
Дальше — два фоновых стока, которые разносят запись в Scylla (постоянный журнал обновлений) и в Redpanda (шина для поиска и всего остального). Оба идемпотентны и оба переживают повторный прогон, поэтому им разрешено отставать и падать. Это и есть главный размен: согласованность покупается в одном месте — в транзакции, — а дальше система живёт в режиме «догонит».
Честное ограничение: сиквенсер сейчас работает в одной реплике. Таблица лизов под шардирование уже есть и используется схемой, но маршрутизации запросов между репликами не написано. Это добавка сверху, а не переделка, — но пока это так, писать иначе было бы враньём.
#Почему хранилищ несколько
Разные данные ведут себя по-разному, и попытка засунуть их в одну СУБД обычно кончается тем, что она плохо обслуживает оба сценария.
| Хранилище | Что лежит | Почему именно оно |
|---|---|---|
| PostgreSQL | пользователи, диалоги, ключи, состояние сиквенсера | нужны транзакции и связи между сущностями |
| ScyllaDB | ленты сообщений, журнал обновлений | запись всегда в конец, чтение — окном; идеальный кейс для LSM |
| Valkey | сессии, присутствие, pub/sub | горячее, маленькое, переживёт потерю |
| Redpanda | шина событий | нужен повтор с произвольной точки |
| Manticore | поиск по сообщениям | инвертированный индекс, не строки |
Ключевая деталь: доступ к лентам сообщений закрыт отдельным сервисом (message-data), и он единственный, кто ходит в Scylla. Не ради красоты слоёв — ради того, чтобы схему партиционирования нельзя было незаметно нарушить из случайного места кода. Это тот тип границы, который стоит дёшево, пока проект маленький, и который невозможно провести потом.
#Отдельная проблема: как не врать себе о готовности
У Telegram примерно 781 вызываемый метод — это число получено рефлексией по клиентской библиотеке gotd/td, а не на глаз. Реализовать все — не цель. Проблема в другом: в проекте такого размера очень легко потерять счёт тому, что действительно работает.
Поэтому каждый метод живёт в манифесте в одном из трёх состояний: реализован, сознательно не поддерживается, запланирован. Переход в «реализован» не засчитывается без реального e2e-теста против живой инфраструктуры. Однажды манифест поймал 188 методов, которые числились «запланированы», хотя код под ними уже был, — и ровно так же он не даёт числу в README потихоньку превратиться в маркетинг.
Второе решение того же класса: любой корректно разобранный метод, у которого нет обработчика, получает нормальный протокольный rpc_error с METHOD_NOT_IMPLEMENTED. Не оборванное соединение, не пустой успех. Клиент узнаёт правду и продолжает работать — а разработчик видит в логах ровно то, чего не хватает.
#Что из этого стоит забрать
- ▸Протокол — это транспортный слой. Всё, что можно вынести из него в общее ядро, надо вынести, иначе второй вход неизбежно разъедется с первым.
- ▸Атомарность нужна ровно в одной точке — там, где выдаётся порядковый номер. Всё остальное можно сделать догоняющим, если оно идемпотентно.
- ▸Хранилище выбирают по форме нагрузки, а не по привычке; но доступ к каждому лучше закрыть одним владельцем.
- ▸Прогресс надо измерять машиной. Число, которое нельзя проверить тестом, всегда со временем становится оптимистичным.